ローカル環境でRAG(検索拡張生成)を構築する手順|画像生成と会話するAIの魅力と可能性
https://note.com/chat_gpt777/n/n639d524eb7b8
AnythingLLMとLM Studioを連携させて、ローカル環境でRAG(検索拡張生成)を構築する手順を分かりやすく解説します。
あなたの環境(Windows 11 + LM Studio + Gemma 4 + AnythingLLM)であれば、以下の手順で「自分専用のプライベートなAI」を構築できます。
全体の仕組み
1. LM Studio: AIモデル(Gemma 4)を動かし、APIサーバーとして機能させる。
2. AnythingLLM: ユーザーインターフェース。文書の読み込み(RAG)、ベクトルデータベースの管理、LM Studioとの接続を行う。
ステップ1:LM Studioでの準備(AIサーバーの起動)
まず、LM Studio側でAIモデルを「外部(AnythingLLM)から呼び出せる状態」にします。
1. LM Studioを起動し、左側のメニューから「Local Server(二重矢印のようなアイコン)」を開きます。2. モデルを選択: 上部のドロップダウンから、ダウンロード済みの「Gemma 4 12B QAT」を選択します。3. サーバーを起動: 「Start Server」ボタンを押します。
この時、画面上に `http://localhost:1234` というURLが表示されるはずです。これを控えておきます。4. サーバーを起動したままにする: AnythingLLMを使う間は、LM Studioはこのまま開いた状態でにしておきます。
ステップ2:AnythingLLMの設定(接続設定)
次に、AnythingLLMに「AIはLM Studioにいるよ」と教えてあげます。
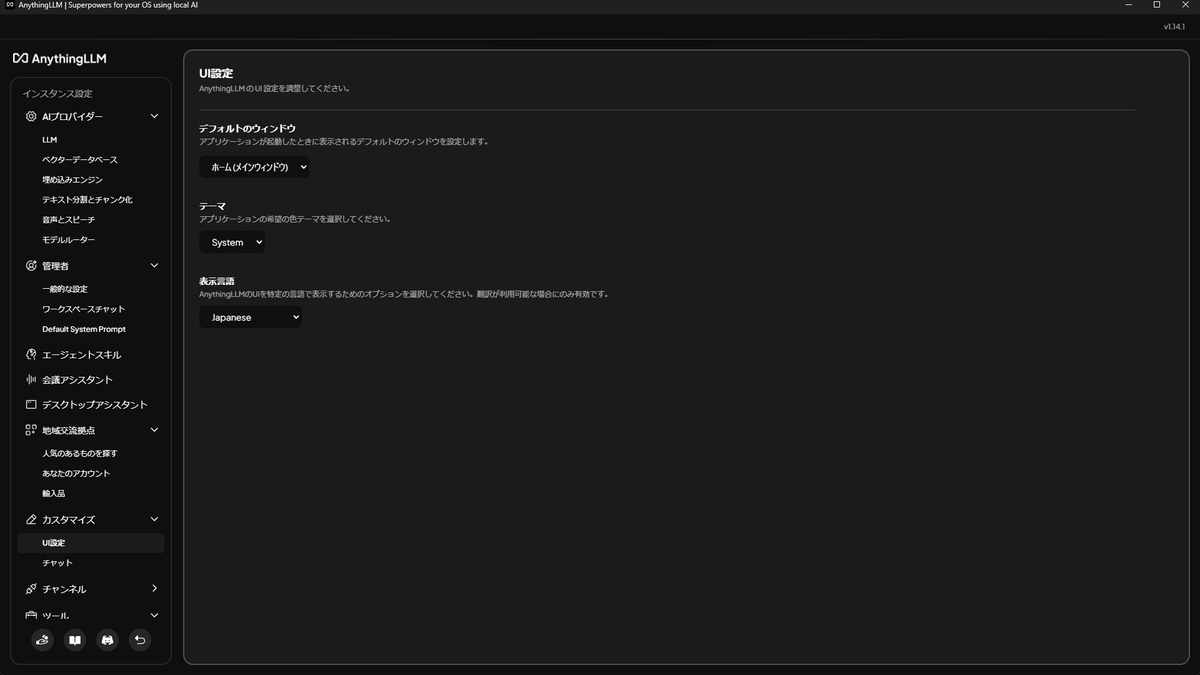
1. AnythingLLMを起動し、設定(Settings)を開きます。
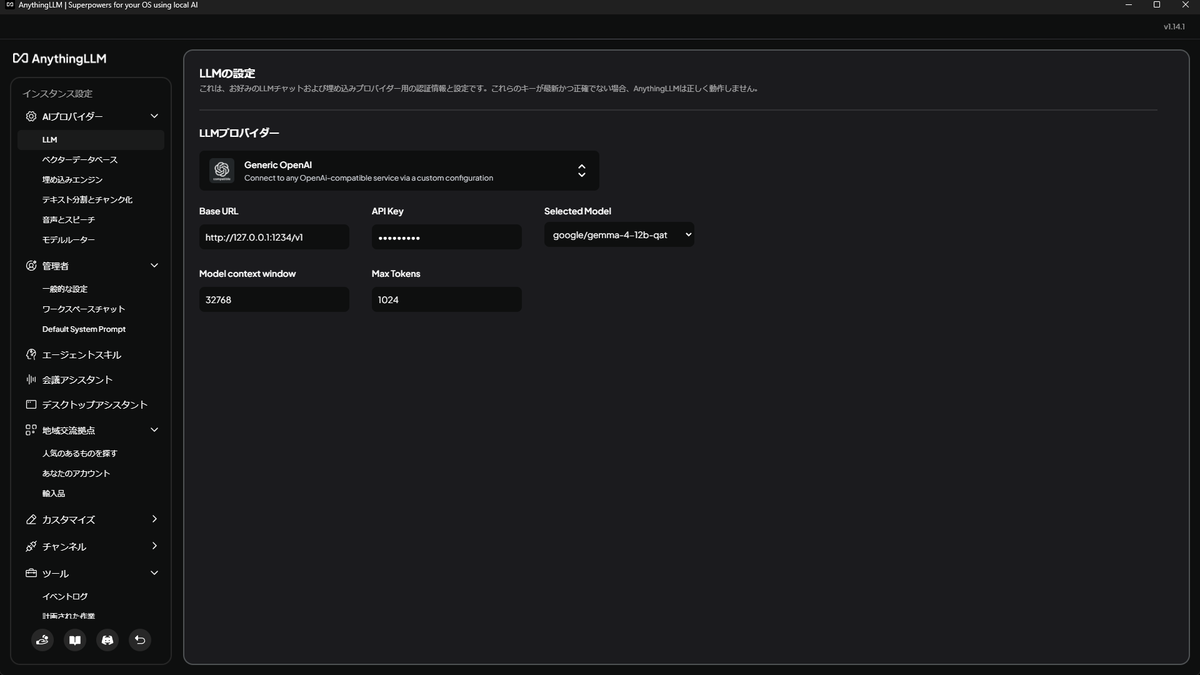
2. LLM Provider(LLMプロバイダー)の設定:
LLM Provider: 「LM Studio」を選択します。
LM Studio API URL: 先ほど確認した `http://localhost:1234/v1` を入力します(最後に `/v1` を付けるのが一般的です)。
Model Name: LM Studioで読み込んでいるモデル名(例: `gemma-4-12b-qat`)を入力します。
3. Embedding Model(埋め込みモデル)の設定:
※RAG(文書検索)を行うために必要です。
特にこだわりがなければ、AnythingLLMの「Built-in(内蔵)」のモデルを選択すればOKです。
4. 保存: 設定を保存します。
ステップ3:ワークスペースの作成と文書の登録(RAGの実行)
ここが「RAG」の核心部分です。
1. ワークスペースの作成: AnythingLLMのホーム画面で「New Workspace」を作成します(例:「仕事資料」や「趣味の論文」など)。
2. 文書のアップロード: ワークスペースに入り、PDF、Word、テキストファイルなどをアップロードします。
3. 埋め込み(Embedding)の実行:
アップロードしたファイルを選択し、「Move to Workspace」をクリック。
その後、「Save and Embed」ボタンを押します。
※ここでAIが文書の内容を解析し、検索可能な状態(ベクトル化)にします。
ステップ4:チャットを開始する
1. 作成したワークスペースを開きます。
2. 質問を入力: 「この資料の結論を要約して」や「〇〇について書かれている箇所を教えて」と入力します。3. 回答の確認: AnythingLLMが内部で文書を検索し、その内容をGemma 4に渡して、根拠に基づいた回答を生成します。
運用のポイント
プライバシー: この構成では、すべての処理(AIの推論も、文書の解析も)があなたのPC内だけで完結します。外部(インターネット)にデータが送信されることはありません。
GPUの活用: LM Studio側でGemma 4を動かす際、可能な限りGPU(ビデオカード)を割り当てるように設定すると、回答の速度が大幅に向上します。
モデルの切り替え: もしGemma 4の回答が物足りない場合は、LM Studioで別のモデルを読み込み、AnythingLLMの接続設定を書き換えるだけで簡単に変更可能です。
RAG(Retrieval-Augmented Generation)は、日本語で「検索拡張生成」と訳されます。
一言で言えば、「AI(LLM)に、あらかじめ用意しておいた外部知識(あなたの持っている資料など)を『カンニングペーパー』として見せながら回答させる仕組み」のことです。
なぜこの仕組みが必要なのか、どう動くのかを詳しく解説します。
1. なぜRAGが必要なのか?(LLMの弱点)
ChatGPTやGemma 4のようなLLM(大規模言語モデル)には、主に2つの弱点があります。
知識の鮮度(カットオフ): AIの学習が終わった後の出来事(昨日のニュースや、今日公開された論文など)は知りません。
プライベート情報の欠如: あなたの会社の社内規定、個人の日記、特定のプロジェクトの資料などは、AIの学習データには含まれていません。
ハルシネーション(嘘): 知らないことでも、もっともらしく嘘をついて回答してしまうことがあります。
RAGを使うことで、これらの弱点を克服できます。
2. RAGの仕組み(4つのステップ)
あなたがAnythingLLMで質問をしたとき、裏側では以下のプロセスが瞬時に行われています。
① 質問の解析と検索(Retrieval:検索)
ユーザーが「この資料の予算について教えて」と質問すると、システムはまず、あなたがアップロードした膨大な資料の中から「予算に関する記述が含まれている部分」だけを高速に探し出します。
ここで使われる技術が「ベクトル検索」です(文章の意味を数値化して、似ているものを見つけ出します)。
② プロンプトへの組み込み(Augmentation:拡張)
システムは、ユーザーの元の質問と、ステップ①で見つけた「資料の該当箇所」を合体させ、AIへの指示書(プロンプト)を作り変えます。
元の質問: 「この資料の予算について教えて」
RAGによる拡張後の指示: 「以下の【参考資料】に基づいて、ユーザーの質問に答えてください。資料にないことは『わかりません』と答えてください。
【参考資料】:『2024年度予算案:総予算は500万円であり、うちマーケティング費に200万円を充てる。』」
③ 回答の生成(Generation:生成)
AI(Gemma 4など)はこの「拡張された指示書」を読み、資料の内容を根拠にして回答を生成します。
④ ユーザーへの回答
ユーザーには、資料に基づいた正確な回答が届きます。
3. わかりやすい例え:「試験の形式」
RAGの仕組みを試験に例えると、非常に分かりやすくなります。
通常のLLM(学習のみ): 「記憶力だけで解く試験」
AIは自分の記憶(学習データ)だけで答えます。記憶が曖昧だと間違えたり、記憶にないことをでっち上げたりします。
RAG: 「教科書を見ながら解く試験(オープンブック・テスト)」
AIは目の前にある教科書(あなたがアップロードした資料)を読んでから答えます。記憶力よりも「正確に読み取ってまとめる能力」を使い、正確性が飛躍的に向上します。
4. RAGを使うメリット(あなたの環境での利点)
あなたがAnythingLLMを使ってRAGを構築する最大のメリットは以下の3点です。
1. 圧倒的な正確性: AIの「思い込み」による嘘を減らし、提供した資料に基づいた事実を回答させることができます。
2. 最新・個別情報の活用: AIを再学習(ファインチューニング)させる必要はありません。新しいPDFをフォルダに入れるだけで、その瞬間にAIがそれを「知っている」状態になります。
3. 情報のソース(根拠)の特定: 多くのRAGシステム(AnythingLLM含む)では、どの資料のどこを参考にしたかを表示できるため、情報の裏取りが容易です。
結論として:
RAGは、「AIを賢くする(再学習させる)」のではなく、「AIに正しい資料を渡して、正しく答えさせる」ための技術です。これが、AnythingLLMが非常に人気がある理由です。