Gemma 4 QATを試してみた ― 高性能なローカルLLMがさらに身近に|画像生成と会話するAIの魅力と可能性
https://note.com/chat_gpt777/n/nc795b5695e3f
米Google DeepMindは、「Gemma 4」ファミリー向けの「Quantization-Aware Training(QAT)」版モデルを公開しました。QATは、学習段階から量子化を考慮することで、メモリ使用量を大幅に削減しながらモデル品質を維持することを目的とした技術です。
今回公開されたQAT版は、「E2B」「E4B」「12B」「26B MoE」「31B」の各モデルに対応しています。
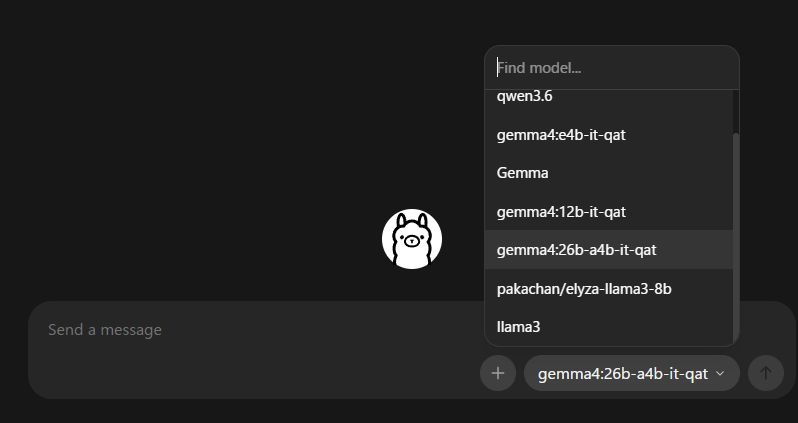
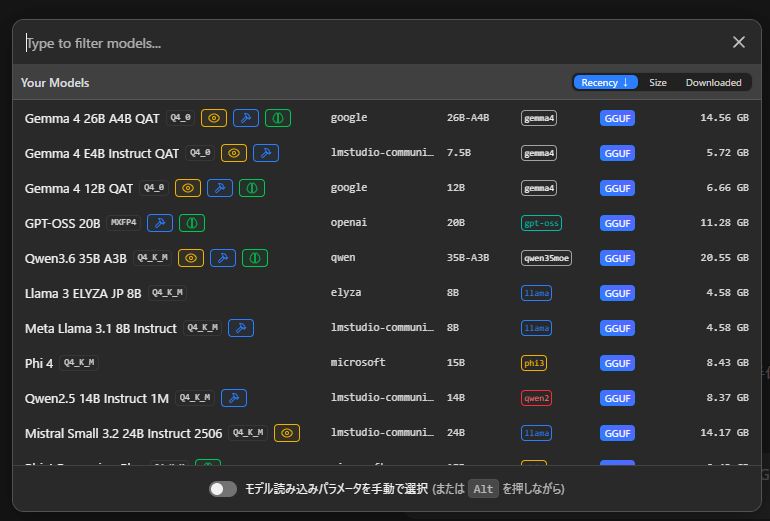
私は先日公開された「Gemma 4 12B」を導入し、軽快に動作するローカルLLMとして活用していましたが、今回新たに公開されたQAT版にも注目し、以下のモデルをインストールして試してみました。
・google/gemma-4-e4b-qat
・google/gemma-4-12b-qat
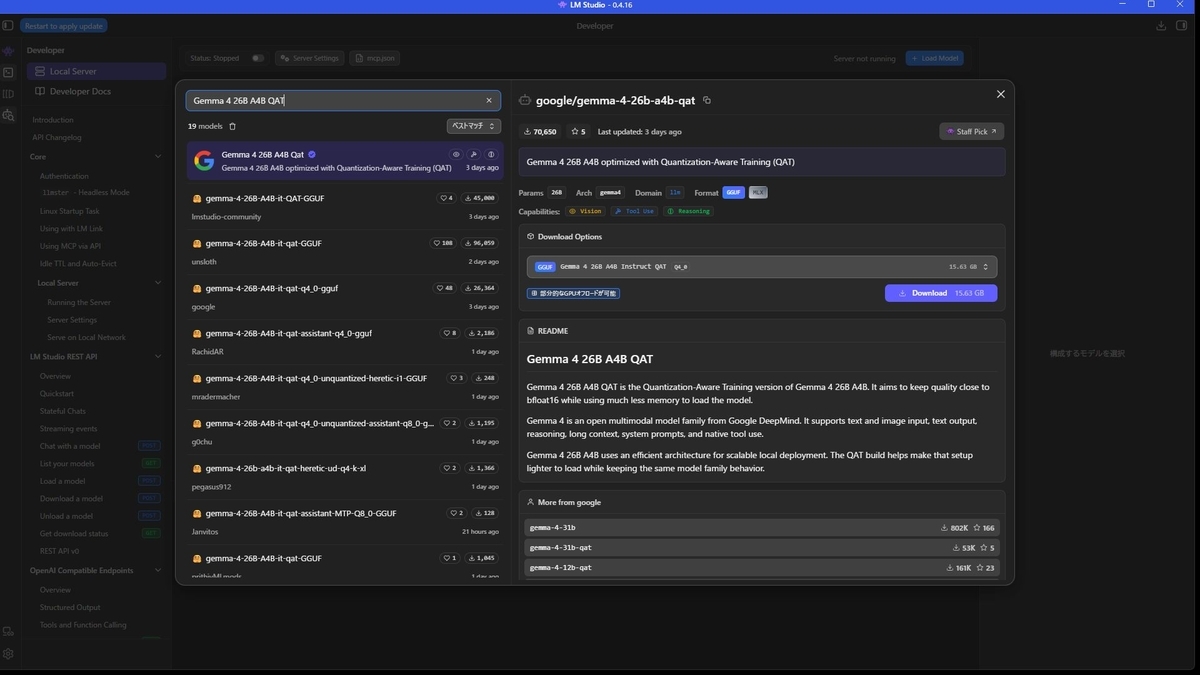
・google/gemma-4-26b-a4b-qat
今回はOllamaとLM Studioの両方で動作を確認しました。
実際に使ってみると、どのモデルも非常に快適です。特に「gemma-4-12b-qat」はレスポンスが速く、日常利用における使い勝手の良さが際立っています。一方、「gemma-4-26b-a4b-qat」は12Bより処理速度はやや遅いものの、回答の質や推論能力の高さが印象的でした。「google/gemma-4-e4b-qat」は凄く早い、驚愕の速さで超快適、でも中身はちょっと不満かな?
私が試した環境では、6月8日の時点では導入できなかったものの、6月9日にはLM StudioおよびOllamaの両方で問題なく利用できるようになりました。
Gemma 4シリーズの魅力は、単なるテキスト生成にとどまりません。画像を入力して内容を分析したり、OCR(文字認識)を行ったりできるマルチモーダル機能を備えています。日本語能力も高く、実際に試した範囲では自然で信頼性の高い応答が得られました。
何より大きな魅力は、オフライン環境でも利用できることです。文章や画像、音声データなどを外部のクラウドへ送信せずに処理できるため、プライバシーや機密性を重視する用途でも安心感があります。モデル自体の利用料は無料であり、必要なのはPCと電力だけです。
一方で、ローカルLLMならではの変化も感じました。これまでは比較的静かだった私のPCですが、Gemma 4を動作させるとGPUの冷却ファンが勢いよく回り始めます。AIが実際に自分のPC上で動いていることを、耳でも実感できます。
また、以前利用していた通常版の「Gemma 4 26B」と比較すると、今回の「Gemma 4 12B QAT」は格段に軽快です。私の環境では以前26Bモデルが途中で応答停止やタイムアウトに近い状態になることもありましたが、12Bモデルは非常に安定して動作しました。google/gemma-4-26b-a4b-qatもちゃんと動作するようになりました。
Gemma 4 12Bは約120億パラメーターを持ち、マルチモーダル対応や140以上の言語サポートなど、多くの機能を備えています。モデルサイズも比較的コンパクトで、16GB以上のRAMを搭載したPCであれば十分に実用になるでしょう。
ChatGPT、Gemini、Claudeといったクラウド型AIには依然として強みがあります。しかし、ローカル環境で自由に利用できるGemma 4 QATは、「自分専用のAI」を手元で動かしたい人にとって、非常に魅力的な選択肢になりそうです。
「Gemma 4」のメモリ消費を大幅削減する「QAT」、品質はそのままスマホ上でも十分動作
https://forest.watch.impress.co.jp/docs/news/2115073.html
目白押しに新しいシリーズが出てきますね。
Google、ローカルAIが4倍速くなるテキスト生成モデル「DiffusionGemma」を実験的に発表、
逐次ではなく一括で生成
https://forest.watch.impress.co.jp/docs/news/2116179.html